Qué es NSAdaSync
nsadasync (NSAdaSync) es la réplica de Adabas de Nacarsoft: mantiene
ficheros Adabas (Open Systems) sincronizados con Oracle, PostgreSQL,
MySQL, MariaDB, SQLite, MSSQL, MongoDB, Elasticsearch y Kafka. Los cambios
salen del núcleo con un user exit
(ADAUEX_4), un supervisor interno los lee del pipe FIFO y los publica en el
broker nsmq embebido (en proceso, sin TCP), y los consumidores aplican
cada suscripción (fichero → tabla/colección/tópico/índice) en el destino,
con carga inicial, checkpoints, DLQ con replay y auditoría
completas.
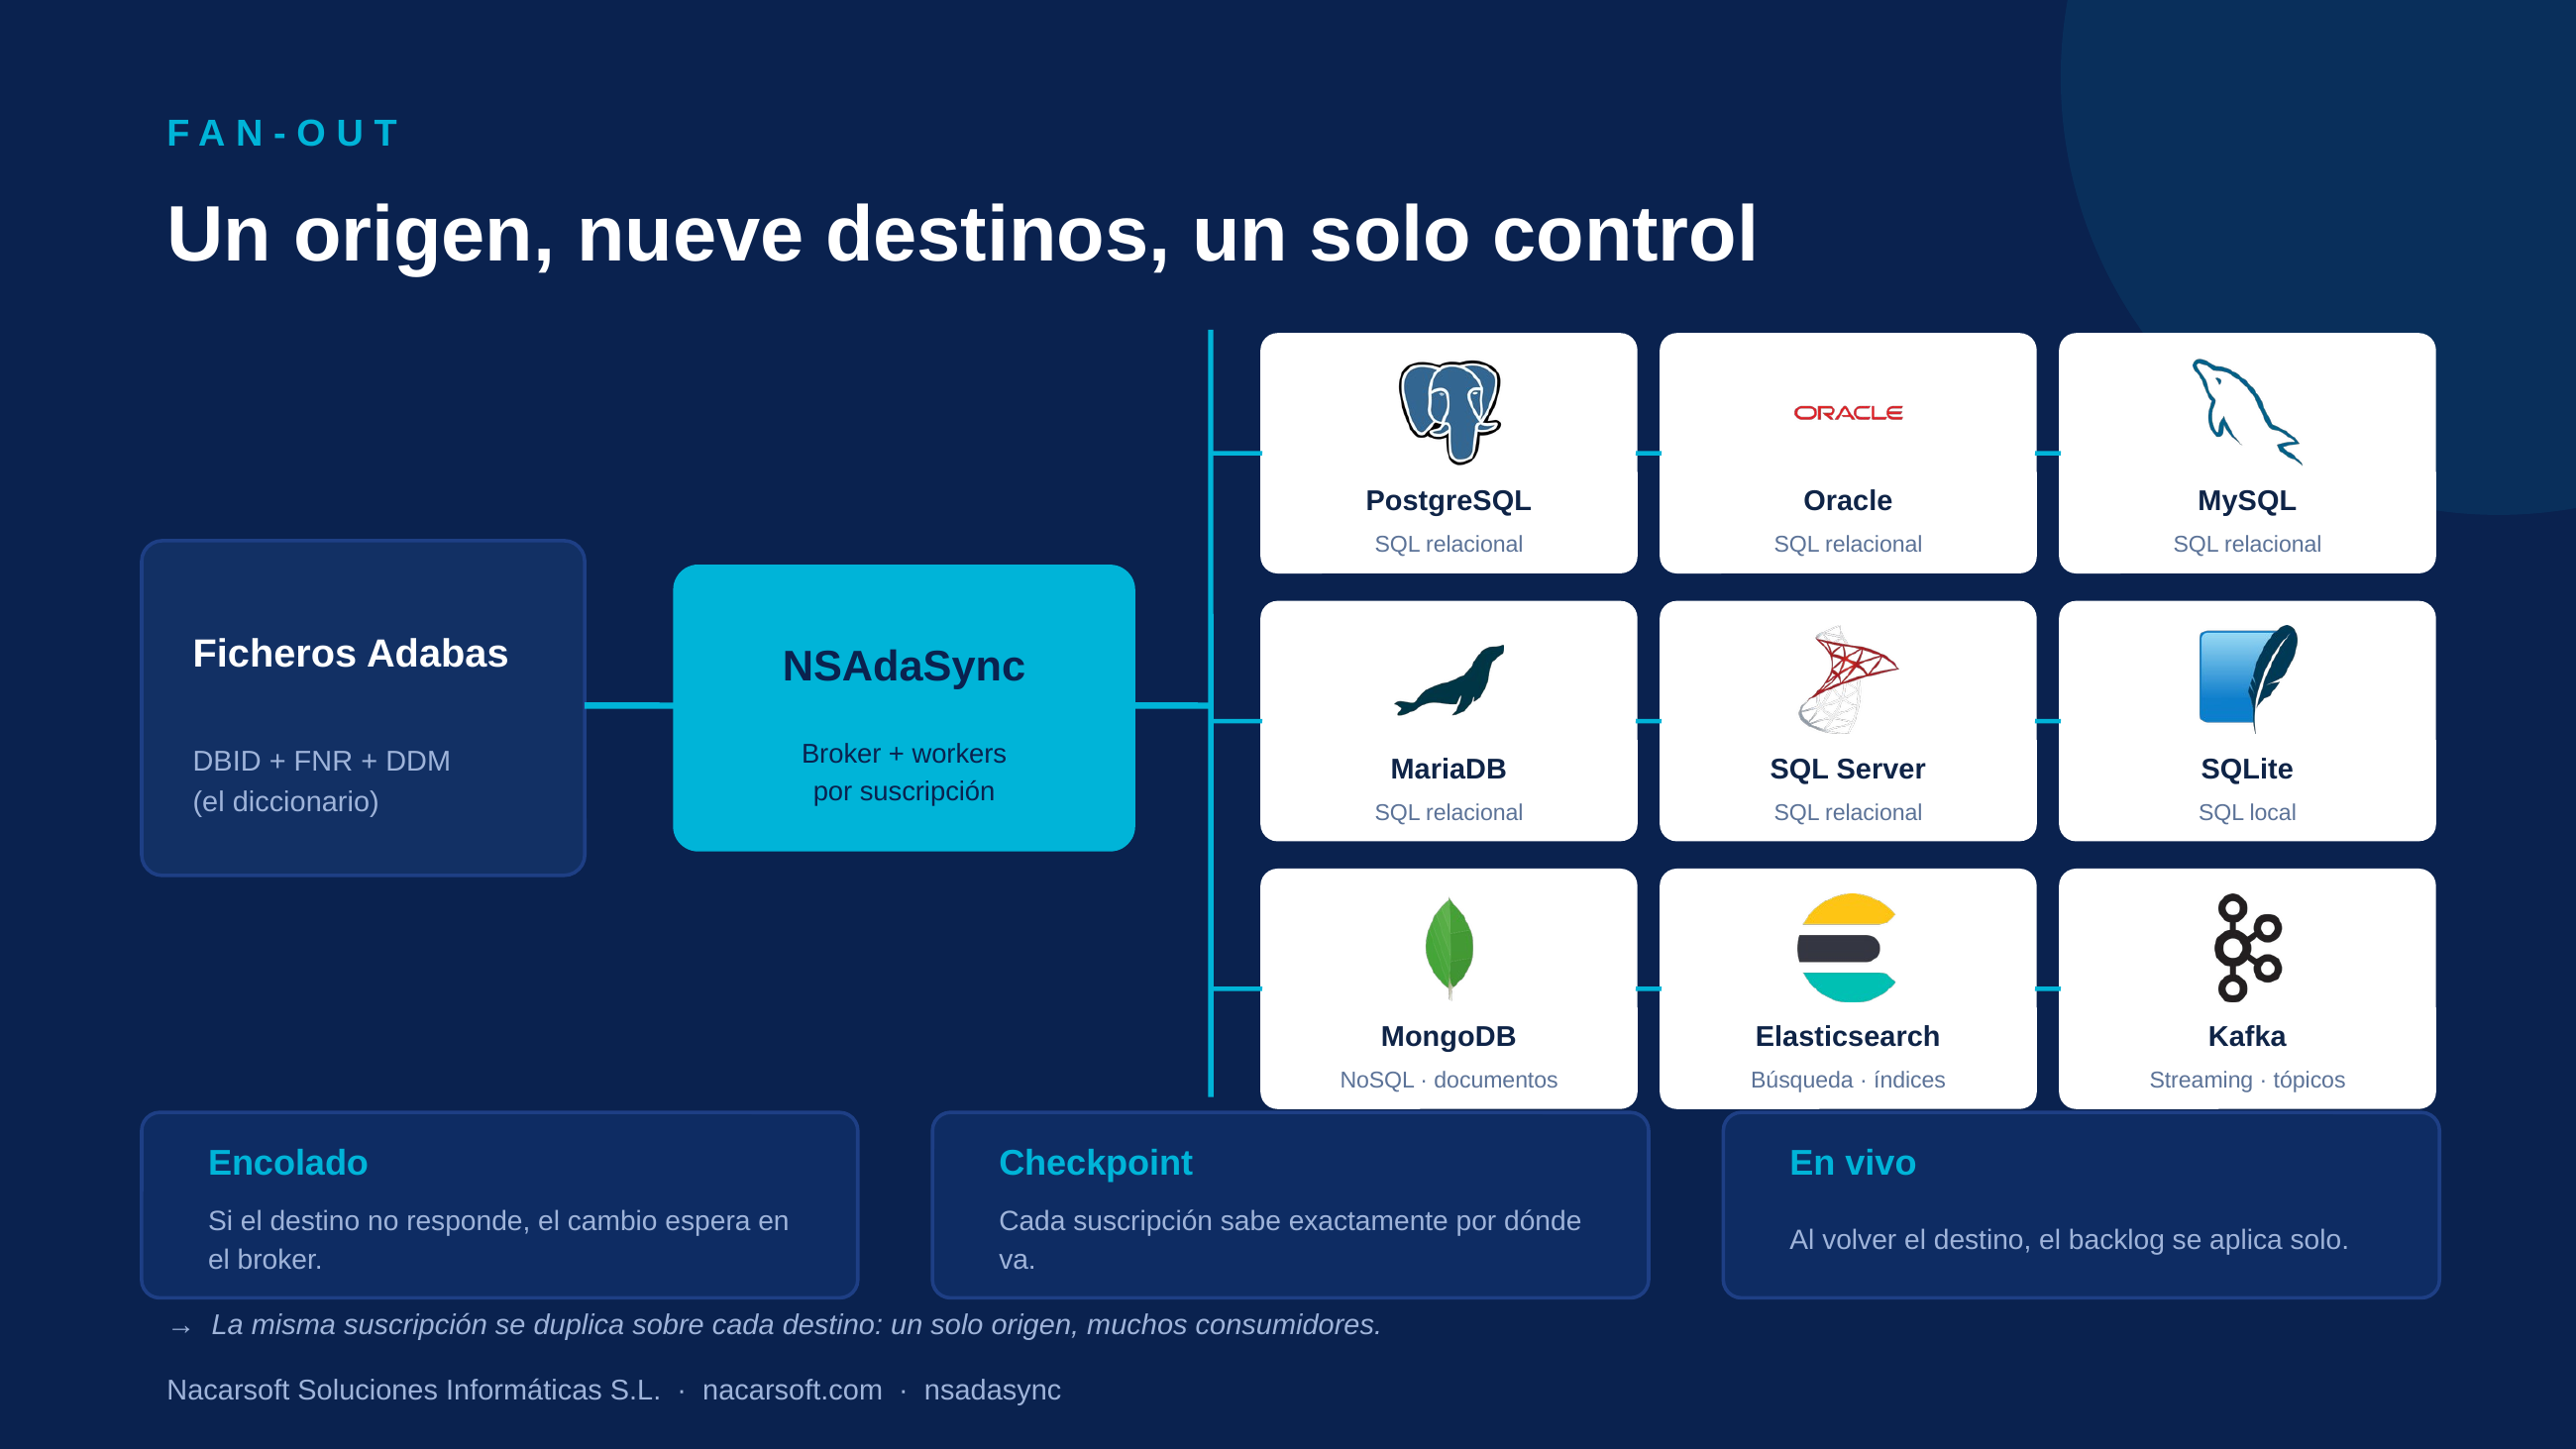
núcleo Adabas --(exit UEX4, frames NSQ2)--> pipe FIFO --(supervisor interno)--> broker embebido
                                                                                         |
                                         +---------------+---------------+---------------+
                                         |               |               |               |
                                      Oracle/PG/       MongoDB /      Kafka (topics   SQLite
                                      MySQL/MSSQL    Elasticsearch    + tombstones)   (WAL)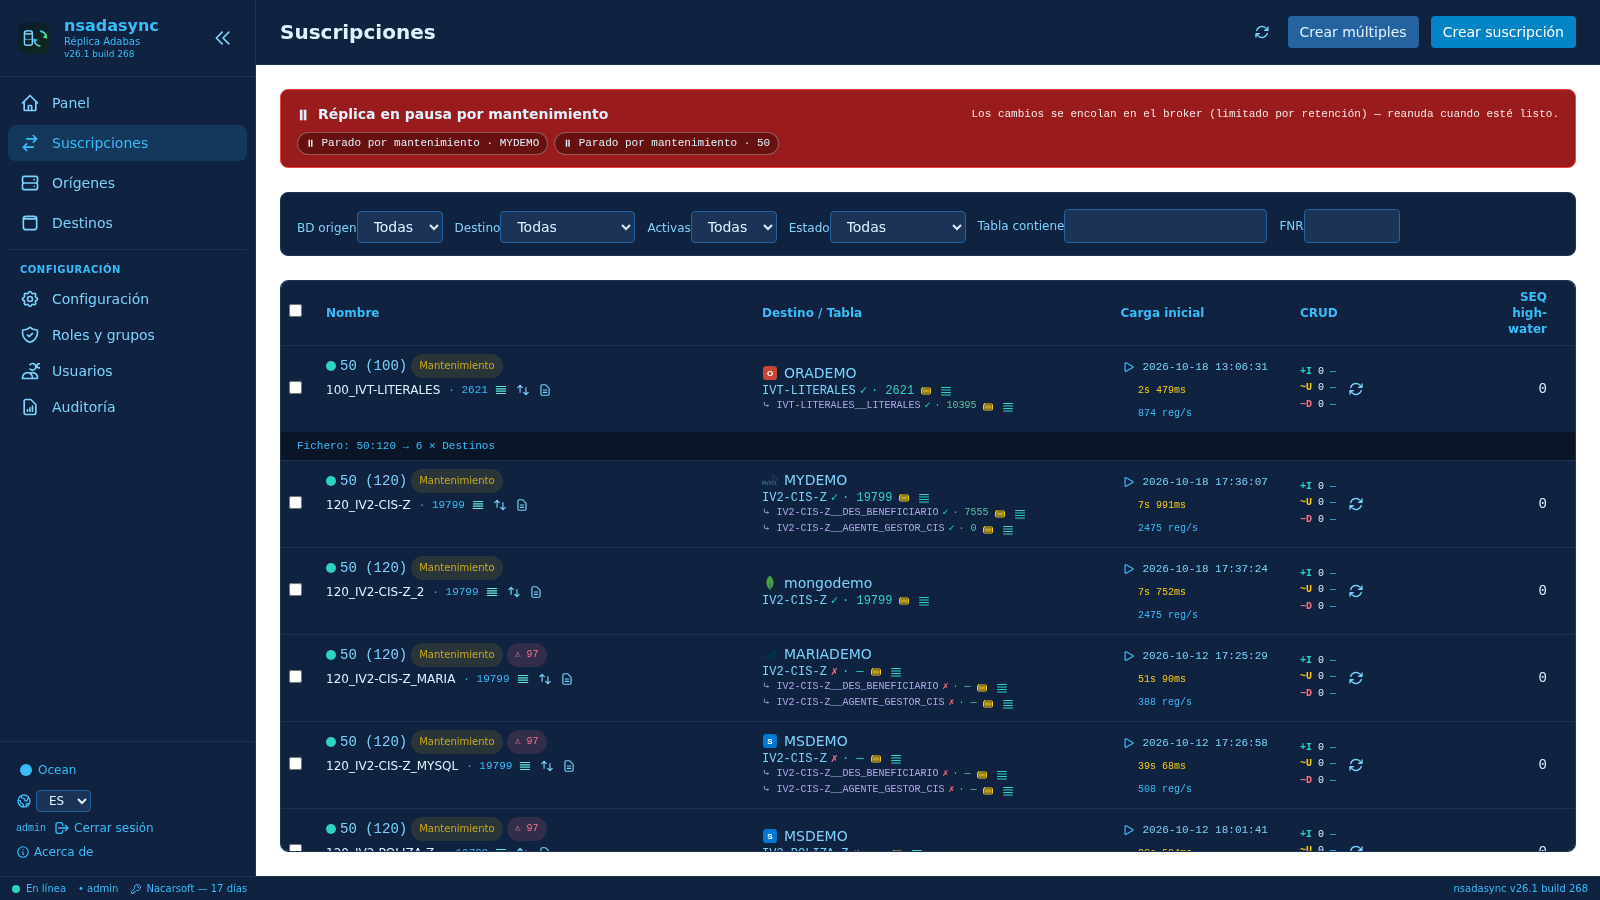
Presentación comercial: PDF (ES) · PPTX (ES) · PDF (EN) · PPTX (EN)
Los nombres de bases, ficheros, tablas y destinos de los ejemplos son ficticios.
Características principales
- Captura mínima en el núcleo: exit UEX4 mínimo (un
writevno bloqueante por registro; nunca bloquea, reintenta ni toca red) + FIFO + lector por origen supervisado en proceso + broker persistente con fsync por batch. - Nueve destinos: Oracle, PostgreSQL, MySQL, MariaDB, SQLite, MSSQL, MongoDB, Elasticsearch y Kafka, con ping/test, inspección de tablas/filas y DDL generado. Sin clientes nativos: drivers integrados.
- Suscripciones fichero → tabla: mapeo de campos del DDM (JSON), MU/PE
como JSON o tablas hijas, identidad por ISN y
upsertcon guarda de recencia_seq(los eventos tardíos no pisan a los nuevos). - Columnas calculadas: campos de marca temporal (
created_aten el insert,updated_aten insert/update) que se rellenan solos al aplicar, y campos Adabas añadidos a mano con sus datos de destino; el botón Aplicar al destino alinea las tablas sin tocar datos. - Carga inicial + streaming: modos
merge/empty/drop, capacidad por destino (max_loads), checkpoints (high_water_seq) y reanudación del backlog tras crear la tabla. La carga valida antes destino accesible y origen activo (409 si alguno está parado). - Panel de destinos y orígenes: estado, latencia, suscripciones y registros encolados por punto, con detalle en tooltip.
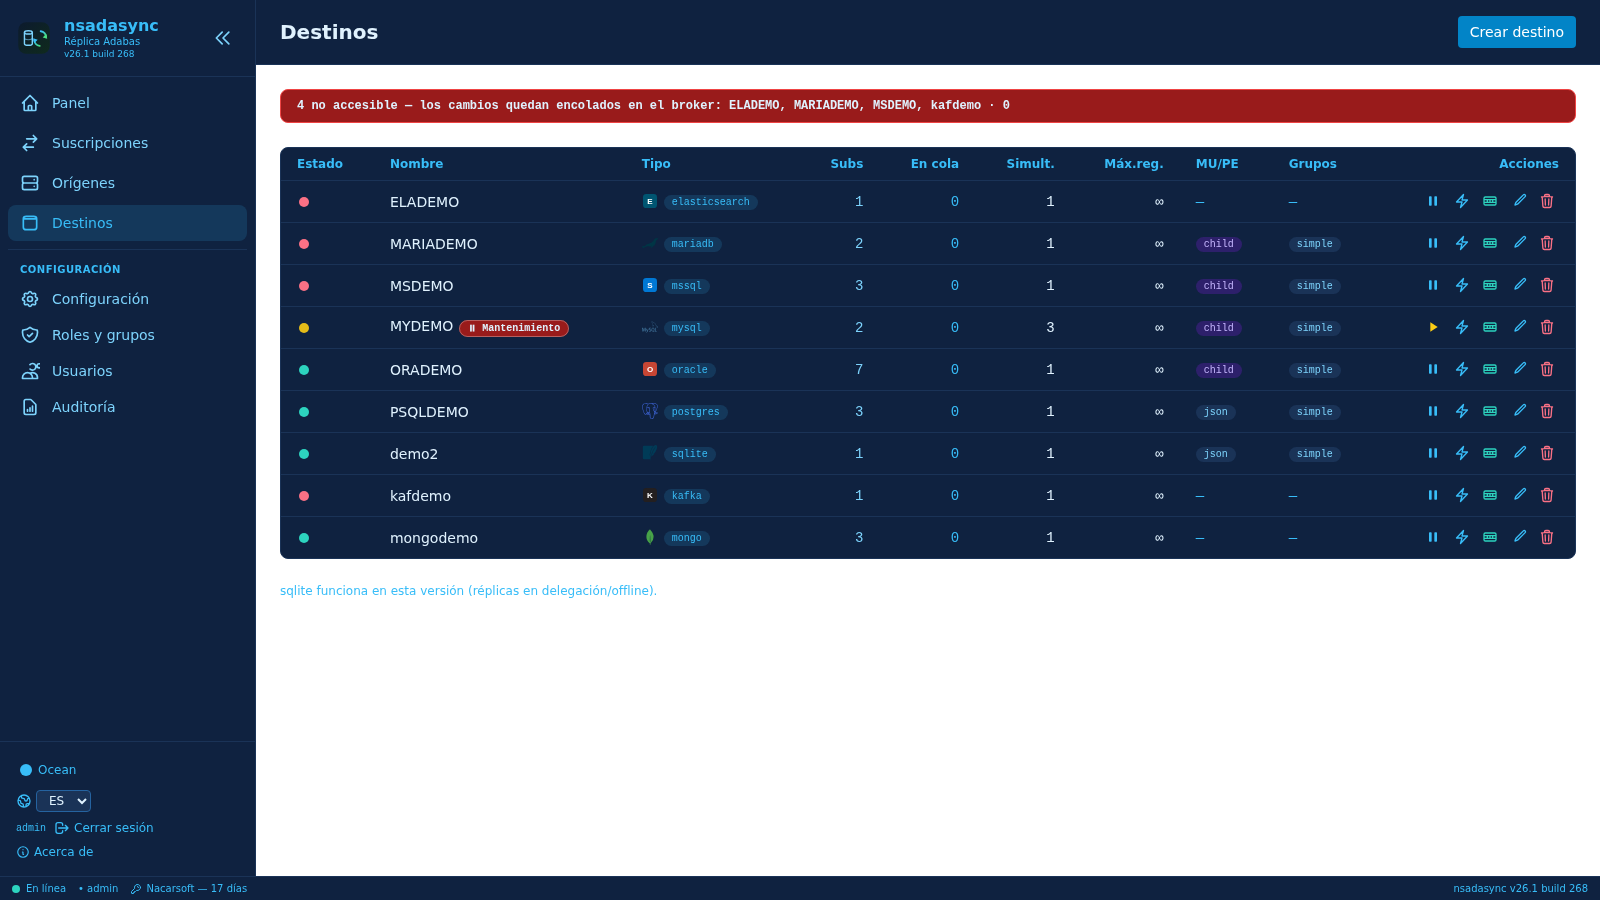
- Destino caído = encolado, no error: si un destino no responde, los cambios esperan en el broker y reanudan solos al volver, sin ensuciar la DLQ.
- Comparación origen ↔ destino por ISN (contadores + diffs por campo), bajo demanda y cancelable; registros de origen y destino en el mismo visor.
- DLQ con replay: los errores no pierden eventos, se inspeccionan y se reintentan; el replay rechaza campos sin mapeo en vez de corromper (los borrados se reintentan por ISN, sin decodificar imagen).
- Historial de cargas con borrado individual o total y antigüedad
(
hace 20h:30m) por ejecución. - Kafka como sink de streaming: un tópico por tabla, clave = ISN, tombstones al borrar (converge con compactación), idempotencia y SASL/TLS.
- Consola web en español e inglés: Panel, Orígenes, Suscripciones, Destinos, Usuarios, Roles, Logs y Config.
- Tokens máquina (
nstm_...) con scope por suscripción, caducidad y allowlist de CIDRs (API máquina actualmente deshabilitada; el tráfico interno no usa tokens). - RBAC (15 permisos, roles
Admin/SyncOperators/Viewers), auditoría de cada acción.
Casos de uso
- Analítica y BI: replicar a Oracle, PostgreSQL, MySQL o MariaDB y alimentar el reporting en directo, sin cargas nocturnas ni ficheros intermedios.
- Streaming de eventos: publicar en Kafka con un tópico por tabla, clave ISN y tombstone al borrar: converge con la compactación y es idempotente.
- Búsqueda y texto: mantener un índice por tabla en Elasticsearch, creado durante la carga inicial y alimentado en vivo.
- Aplicaciones modernas: MongoDB y SQL Server reciben documentos y filas que alimentan APIs y aplicaciones sin tocar el núcleo.
- Varios destinos a la vez: la misma suscripción se duplica sobre cada destino (fan-out) o se crean suscripciones distintas por fichero.
- Consolidación: el Adabas Open Systems pasa a ser la fuente y SQL, NoSQL o las plataformas de streaming pasan a ser consumidores, no al revés.
Requisitos
- Linux (RHEL 8/9) con los binarios precompilados (sin dependencias de compilación).
- Adabas Open Systems con LOGGING (CLOG) y LOGRB,
USEREXITS=4yADAUEX_4=<ruta>/libnsadasync.so(compilado conexits/build.sh). Importante: debe ser unLOGGING = (CB)efectivo — una líneaLOGGING =vacía posterior en el INI lo anula en silencio y la exit no recibe ningún cambio (síntoma: todo replica por cargas pero el streaming no avanza). - Diccionario por origen: JSON de
nsddm(misma semántica quensadabrowse); hasta 8 MiB por fichero. adashow/adarepen el PATH para la sonda de orígenes (el servidor añade/opt/softwareag/Adabas{,/bin}solo).- Proxy inverso con HTTPS en producción (consola
:11035; el broker es embebido y no escucha TCP).
Arranque
# Inicializar (crea config.yaml 0600, db 0600 y usuario admin) y arrancar
./nsadasync init ./data
./nsadasync start ./data
./nsadasync status ./data
./nsadasync stop ./data
Consola web en http://host:11035/ (login admin; cambia la contraseña tras el
primer acceso). Comandos útiles: nsadasync passwd [dir] <usuario> [password]
(recuperar acceso) y nsadasync license (estado, tipo, caducidad y
fingerprint).
Arquitectura
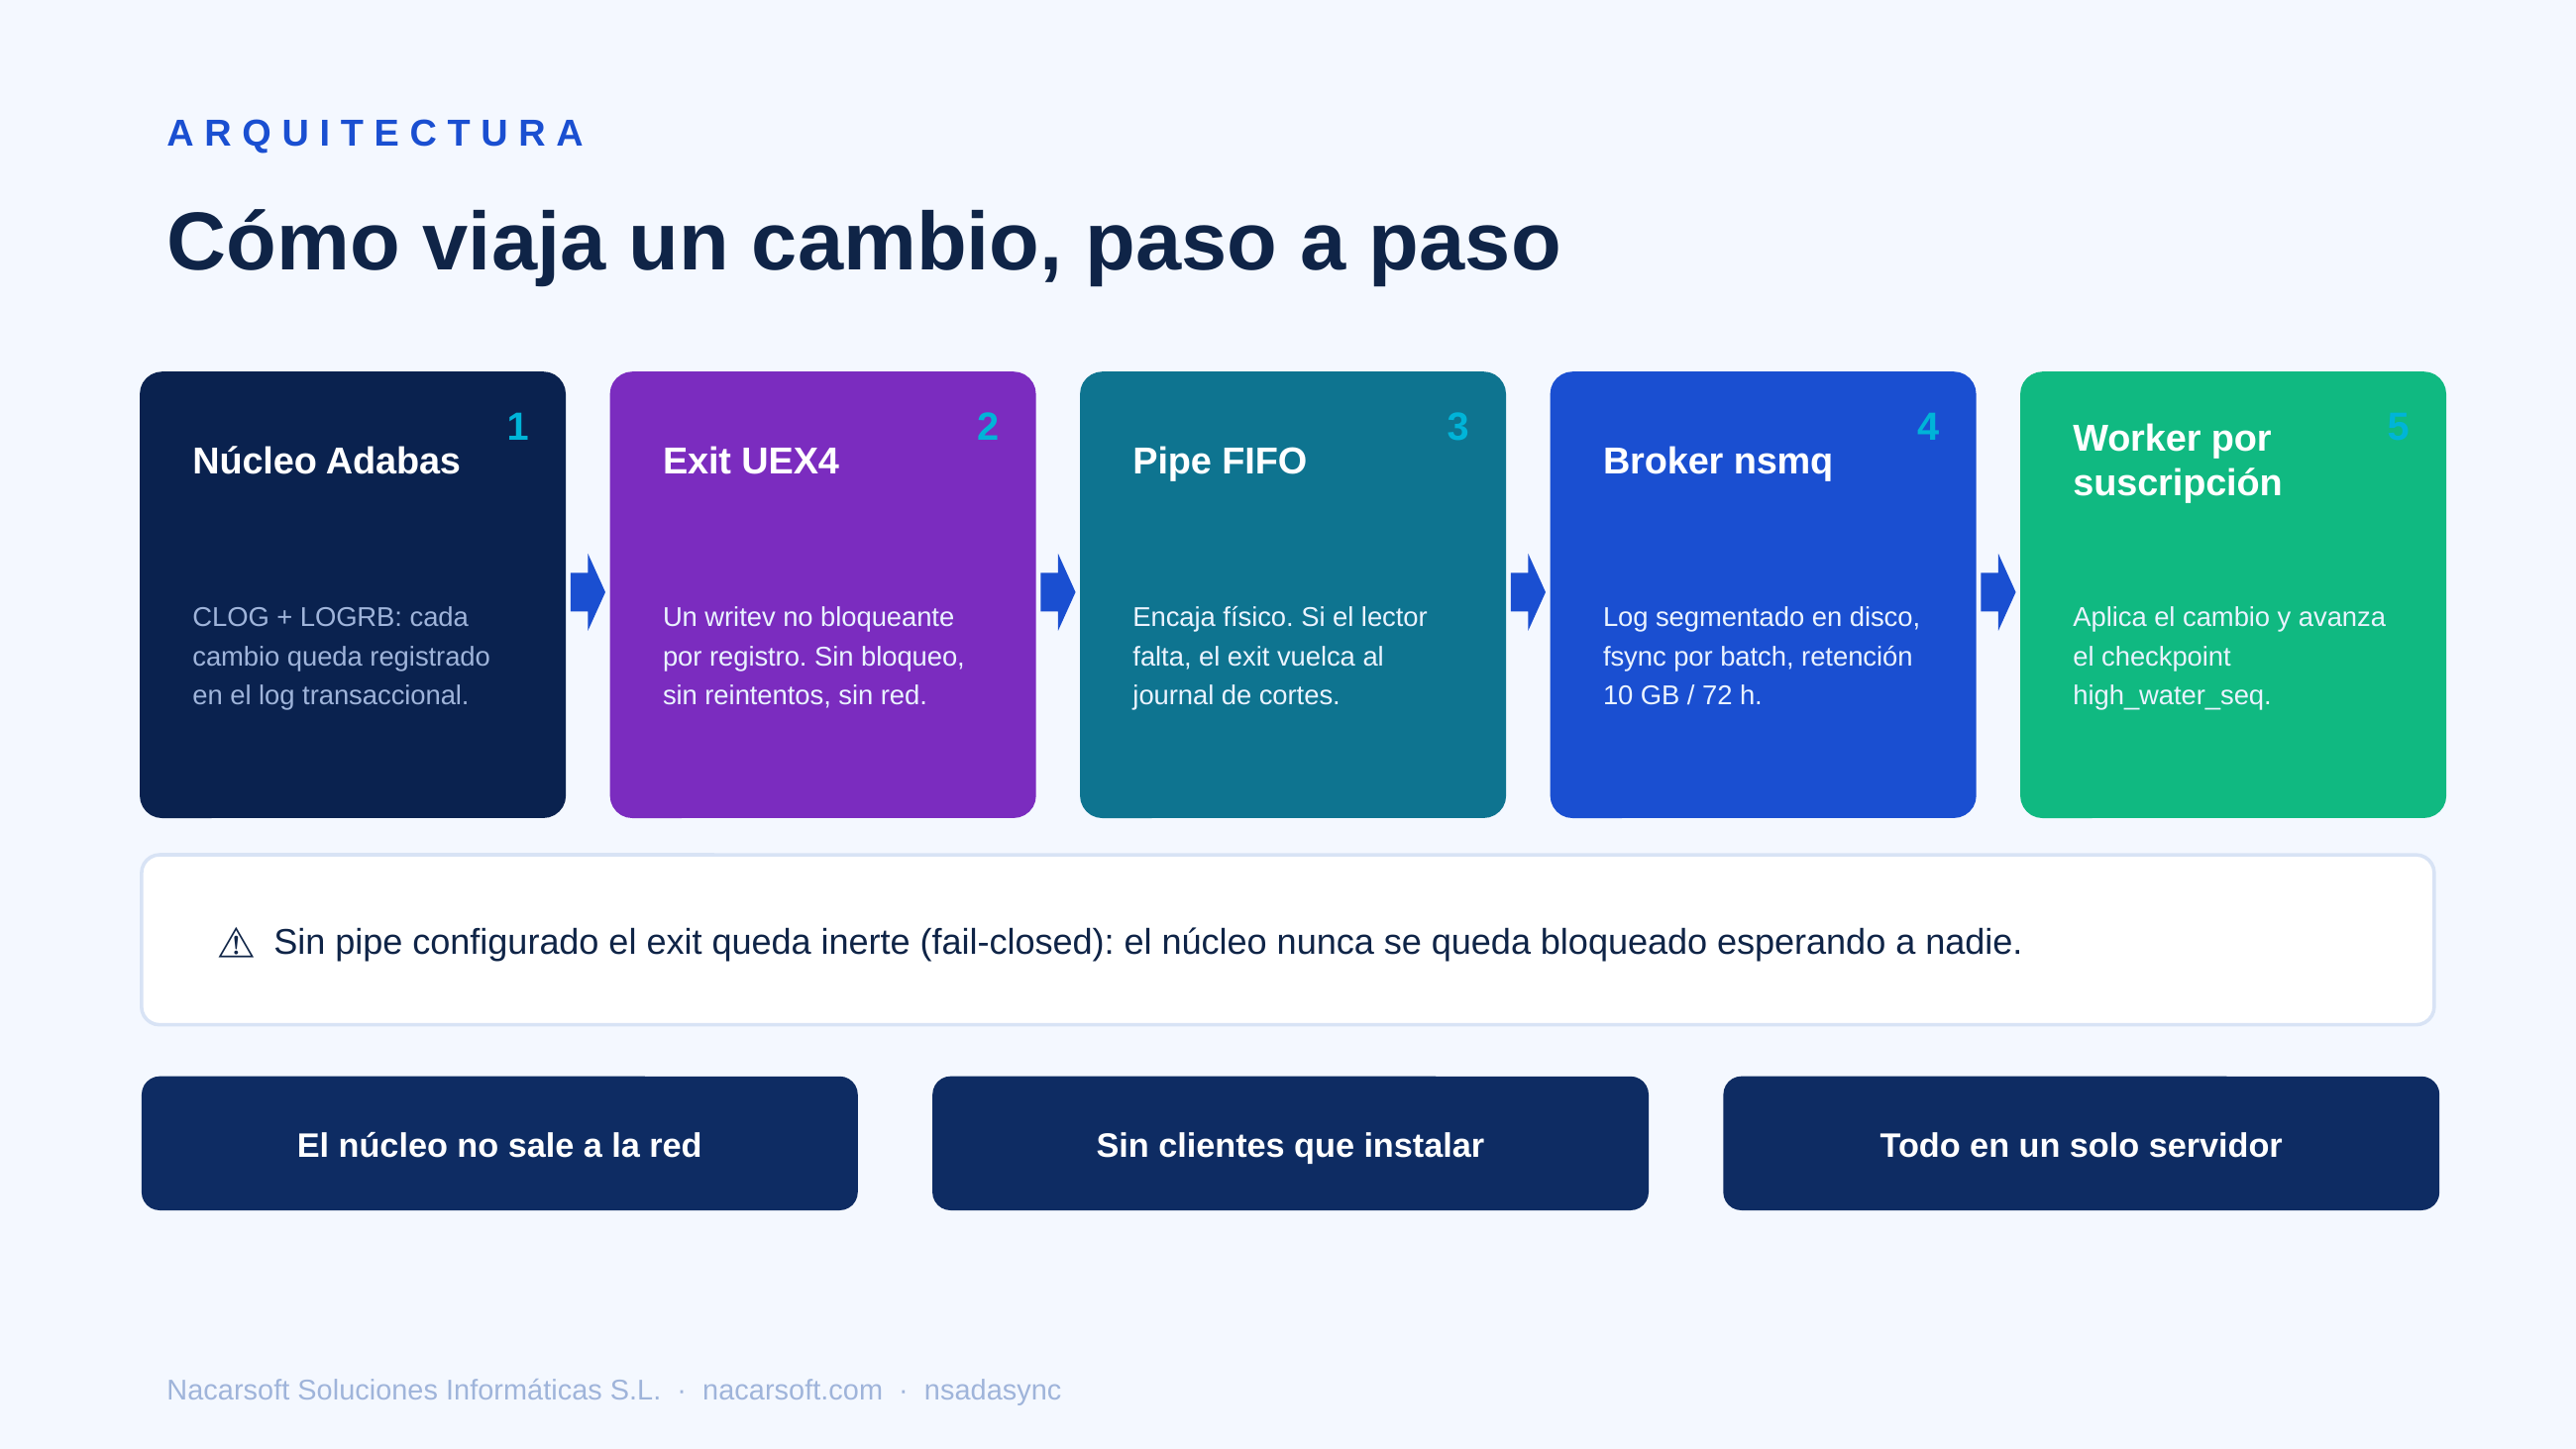
Tres piezas entre el núcleo y el destino, cada una con su observabilidad:
- Exit del núcleo (
exits/libnsadasync.so,ADAUEX_4). Por registro emite un frame binario (cabeceraNSQ2de 76 B + CL/FB/RB crudos; se acepta el legadoNSQ1) con un únicowritevno bloqueante. Captura todo salvo los FNR deNSADASYNC_EXIT_NOFILES; el filtrado por suscripción ocurre aguas abajo (lo no suscrito se descarta antes de publicar, nunca toca disco). Sin pipe explícito queda inerte (fail-closed). Ante cortes vuelca al journal de outage (<pipe>.journal, tope 1 GB) que el supervisor reinyecta. La versión del exit (deexits/VERSION+exits/BUILD) sale en la traza de init. Los borrados viajan sin after-image (fbvacío): se aplican por ISN sin decodificar. - Supervisor de forward (en el servidor, sin proceso ni token aparte).
Mantiene un lector del FIFO por cada origen con
pipe_path(reconcilia cada 30 s), con spool por origen y relectura del journal tras cortes. Publica en el broker por tópicos numéricosadasync.<dbid>.<FNR>: el rendez-vous pipe/journal sale de la fila Origins. - Broker + consumidores (en el servidor). El broker nsmq persiste un log
segmentado por tópico en
data_dircon fsync por batch y aplica retención (retention_bytes10 GB /retention_hours72 h). El consumer manager mantiene un worker por suscripción activa (reconcilia cada 30 s y tras cada alta/baja desde la UI), aplica con el adapter del destino y avanza el checkpointhigh_water_seq. Si el destino no responde, el worker aparca en el broker con backoff (sin avanzar checkpoint, sin DLQ) y reanuda al volver; si la tabla no existe, aparca igual hasta que se crea. Cada suscripción tiene su propio log (logs/subs/<id>.log, rotación a 10 MB) y su contador de errores; condebugregistra cada apply.
Configuración
Orígenes (Adabas fuente)
Cada origen vive en la página Orígenes (SQLite), no en config.yaml:
name (debe ser el DBID numérico, p. ej. 50: los tópicos son siempre
adasync.<dbid>.<FNR>), dbid, config_file (JSON nsddm),
connect, adabas_host/adabas_port (inspección en vivo; vacío = localhost,
puerto 0 = puerto TCP de adashow) y pipe_path/journal_path
(rendez-vous FIFO + journal de cortes; journal vacío deriva a
<pipe>.journal; el pipe debe ser ruta absoluta). Un origen sin pipe no
tiene streaming (solo cargas e inspección).
La consola valida el diccionario al adjuntarlo
(POST /api/adabas/:db/dictionary, hasta 8 MiB, se guarda en
data/ddm/<db>.json), lo recarga (POST .../reload), inspecciona ficheros
(GET /api/adabas/:db/files), campos aplanados con nombres largos
(GET .../files/:fnr, con rutas con puntos DV.DW para PE/MU), el DDM
fuente (GET .../raw?ddm=NOMBRE), detecta ficheros sin suscripción
(GET .../missing-subscriptions, con conteos en vivo) y sondea el núcleo
(GET .../probe, POST .../validate, vía adaprobe + adashow/adarep).
Borrar un origen (DELETE, permiso config.manage) es en cascada: sus
suscripciones (y tablas destino si el destino tiene drop_on_delete), su
DLQ, su historial de cargas y sus topics del broker.
Exit del núcleo
# En el host del núcleo
./build.sh                      # en exits/: genera libnsadasync.so
ADAUEX_4=<ruta>/libnsadasync.so # + USEREXITS=4, LOGGING=(CB) efectivo, LOGRB
Variables del exit: NSADASYNC_EXIT_PIPE (obligatoria),
NSADASYNC_EXIT_NOFILES="(1,2,3)" (FNRs a saltar),
NSADASYNC_EXIT_JOURNAL (defecto <pipe>.journal) y
NSADASYNC_EXIT_DEBUG=1|2 + NSADASYNC_EXIT_DEBUG_FILE (traza 0600 con
tope de 64 MB; el nivel 2 vuelca FB/RB truncados; la marca de arranque
muestra los valores efectivos). Sin pipe el exit queda inerte y lo dice una
sola vez en la traza.
Destinos
| Kind | Conexión | Notas |
|---|---|---|
sqlite | path al fichero (se crea en WAL al darlo de alta) | DDL + inspección completas; max_loads 1 por defecto (serializa escritores) |
postgres/postgresql | DSN postgres://user:pass@host:5432/db | upsert nativo + guarda _seq; los NUL se eliminan solo en texto (en BYTEA se conservan) |
mysql/mariadb | DSN user:pass@tcp(host:3306)/db | upsert nativo + guarda _seq |
mssql/sqlserver | DSN sqlserver://user:pass@host:1433?database=db | upsert + guarda _seq |
oracle | DSN oracle://user:pass@host:1521/SID | Sin cliente nativo (go-ora) |
mongodb/mongo | DSN mongodb://user:pass@host:27017/db (db obligatoria) | Documentos con grupos anidados nativos; colecciones se crean con la carga |
elasticsearch | DSN http(s)://host:9200[/prefijo] | Índices por tabla (se crean con la carga); tipos por campo del mapping |
kafka | DSN kafka://h1:9092,h2:9092[/prefijo][?sasl=…&user=…&pass=…&tls=1] | Solo streaming: sin cargas iniciales ni lecturas; tópico por tabla creado al activar; tombstone al borrar; el borrado conserva el tópico |
Comunes a todos: pe_mode (json|child, defecto json) para los grupos
periódicos, mu_mode (json|flat|child, defecto json) para los campos
múltiples, isn_named
(ISN_<TABLA> en vez de isn), groups_as_json (colapsa grupos PE/MU a
una columna JSON en vez de aplanarlos), skip_supersub (defecto true: oculta
superdescriptores y sus componentes), drop_on_delete (al borrar la
suscripción, borra padre + hijas), max_loads (cargas concurrentes por
destino), max_records (0 = sin tope, limita las cargas), options (JSON
libre). GET /api/destinations/drivers dice qué driver trae el build; usa
ping (destinations.view) y test (destinations.manage) antes de
replicar, e inspecciona tablas y filas (GET .../tables[/:table/rows];
columnas tipadas en SQL y documentos; en colecciones anchas se listan hasta
2048 columnas).
Consola (/config)
Panel por secciones (Server, Correo, License, MQ, Exec…) con guardado en
config.yaml (0600); al guardar indica qué áreas piden reinicio. Botón
Test Email. Secretos también por entorno: NSADASYNC_SMTP_PASSWORD y
NSADASYNC_TOKEN_PEPPER (cambiar el pepper invalida todos los tokens).
Referencia interactiva en /api/docs + /api/openapi.yaml
(apiDocs.access: public|private|off, defecto private).
| Sección | Claves principales (defectos) |
|---|---|
server | host 0.0.0.0, port 11035, trustedProxies [127.0.0.1, ::1] |
auth | jwtSecret (mín. 32), tokenPepper, jwtExpiryMin 15, cookieName session, secureCookies auto |
mq | Embebido sin TCP; data_dir ./mq-data, retention_bytes 10 GB, retention_hours 72, batch_size 200, batch_timeout_ms 100 |
sync.defaults | mu_pe json, conflict upsert |
correo | mailer sendmail|smtp, host/puerto/seguridad/usuario/password/from, sendmailPath, baseUrl (URL pública de los enlaces) |
exec | workDir, timeouts 60/300 s, maxConcurrent 10, topes 1 MB, ratePerMin 600, queuetimeout 20, callRetentionDays 30 (purga diaria de audit/DLQ; 0 = conservar) |
logging/license/updates | Rotación 10 MB × 10, 30 días; trialDays 30; URL de updates |
Uso
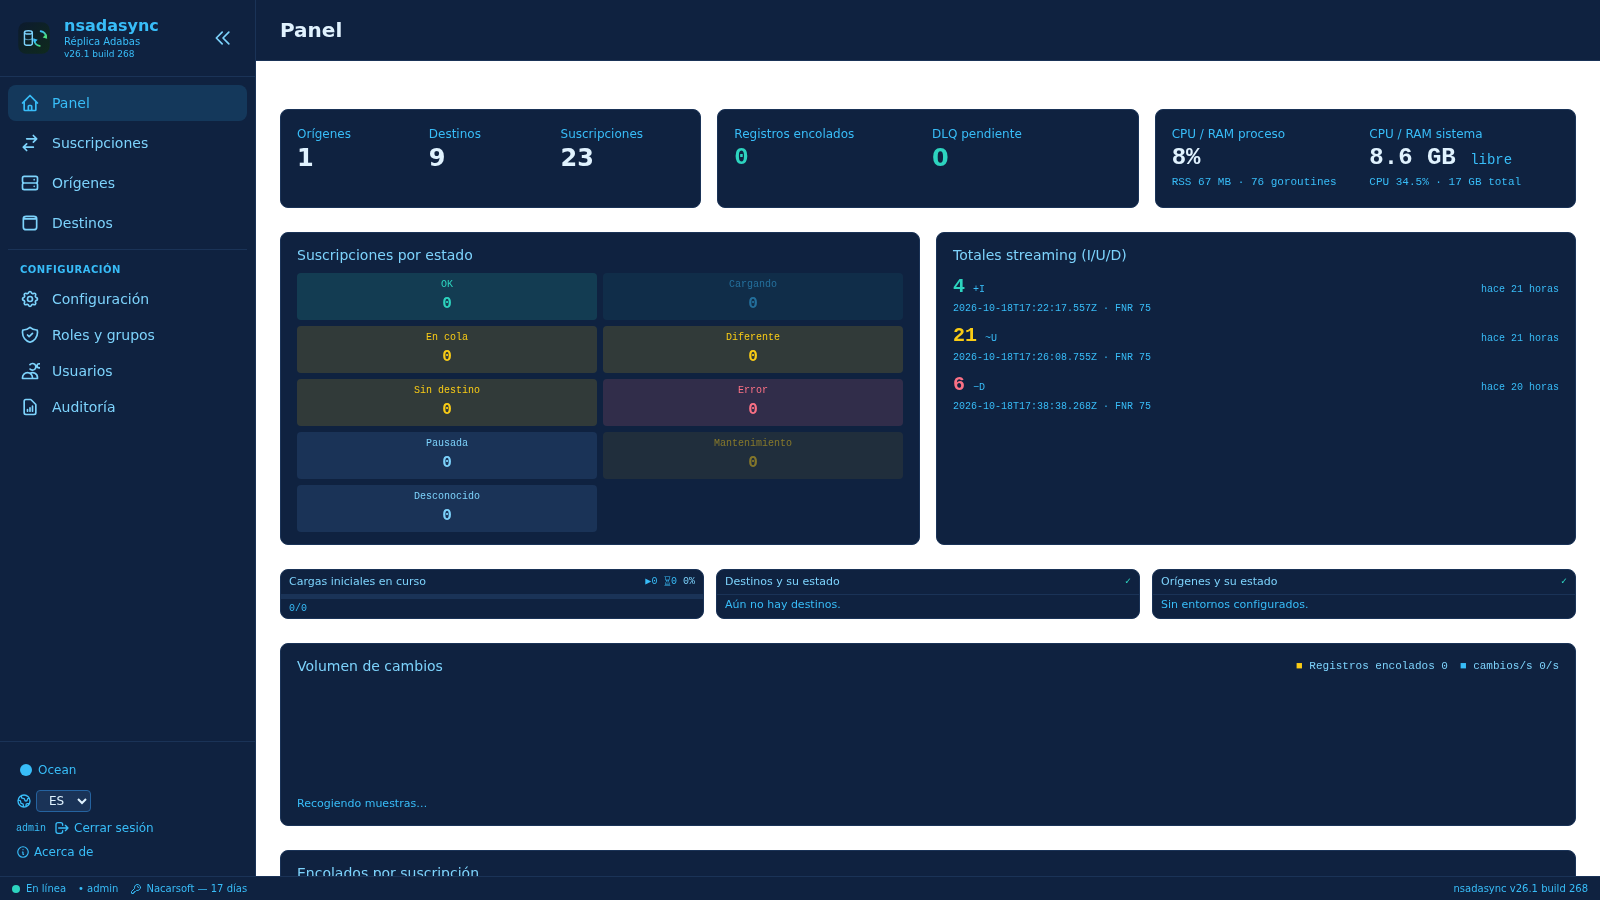
El Panel muestra juntos cargas en curso, destinos y su estado (accesibilidad, latencia, suscripciones y encolados, con detalle en tooltip) y orígenes y su estado (actividad del núcleo y latido del forwarder), además de estados por suscripción, totales I/U/D, gráfica de cambios, encolados por suscripción, salud de la cadena y consistencia.
Suscripciones
Una suscripción = un fichero (origen, FNR, DDM) → (destino, tabla) con
mapeo de campos, pe_mode, mu_mode, mu_flat_max, ddl_override,
is_active y debug. El nombre es único (se sufija por destino) y la pareja
(destino, tabla) no se puede reclamar dos veces. filter_expr se guarda
con la suscripción (reservado). pe_mode y mu_mode vacíos heredan los del
destino; mu_flat_max es obligatorio si mu_mode=flat.
El mapeo es un JSON de columnas [{adabas, column, mode?, type?, length?, precision?, index?, func?}] donde adabas es el nombre corto del
DDM; sin entrada se hereda el tipo del diccionario y la columna por defecto
(nombre largo saneado, corto si falta; en mongo/ES/kafka, la ruta en
minúsculas). index: false desindexa aunque el DDM marque descriptor.
Flujo recomendado: Prepare (POST .../prepare, valida FDT frente al
diccionario) → Preview DDL (POST .../preview-ddl, sin ejecutar) →
Ensure table (POST .../ensure-table, crea padre + hijas + índices y
guarda el último error DDL en la fila) → Load → streaming.
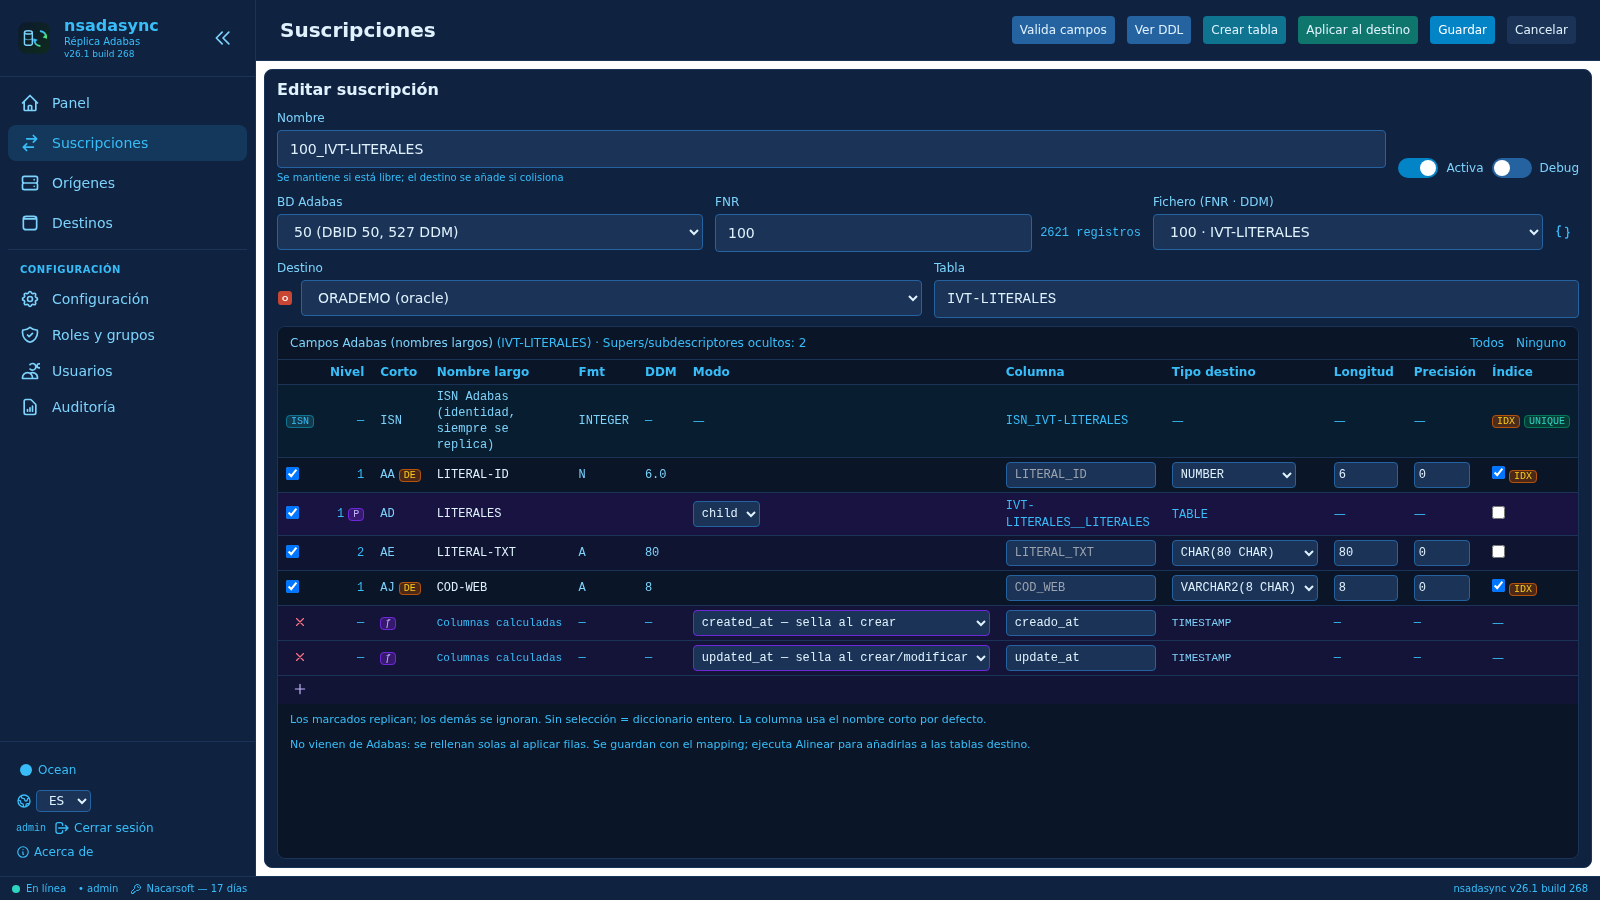
Campos personalizados (botón + en la tabla de campos): abre un modal
para añadir un campo Adabas (elige de la lista de pendientes con nivel,
corto, formato y longitud; defines columna, tipo, longitud, precisión, modo
e índice) o una columna calculada (created_at: sella el momento del
insert; updated_at: insert y update). Las calculadas van siempre al final
y existen en DDL, cargas, streaming y replays. Tras editar, Aplicar al
destino (POST .../align-columns) añade las columnas que falten sin tocar
datos, contadores ni checkpoint (409 si hay carga en curso o la tabla aún no
existe).
Duplicate (POST .../duplicate) clona la suscripción sobre otro destino
(fan-out, hereda filtro y modos); Compare (POST/GET .../compare,
cancelable, 409 si ya corre uno) recorre por ISN y devuelve contadores
(read/total/outdated/missing/extra) + diffs por campo; los registros de
origen se ven en el mismo panel que los de destino (tabla/formulario,
búsqueda por ISN, paginación); debug hace que el worker registre cada
apply (los errores, siempre) en logs/subs/<id>.log; reset-counters
pone a cero contadores; el log por suscripción
(GET .../log?lines=200, máx. 1000; DELETE lo limpia).
| Estado | Significado |
|---|---|
ok | Activa, tabla existe, conteos origen/destino coinciden |
diferente | Solo informativo: el destino va con retardo transitorio; el contenido se verifica con compare |
sin_tabla | Activa sin tabla: el consumidor aparca en el broker sin ensuciar la DLQ; crear la tabla reanuda el backlog (en mongo/ES la crea la carga; en kafka el tópico se crea al activar) |
cargando / en_cola | Una carga inicial posee las tablas (o espera capacidad); live/replay se aparcan |
error | Error del consumidor o DLQ pendiente (ver motivo) |
inactiva | is_active=false (interruptor ON/OFF) |
desconocido | Origen inalcanzable para contar o destino no verificable |
Cargas iniciales, journal y DLQ
Loads (POST /api/loads {subscription_id, mode}, permiso loads.run;
POST /api/loads/batch para varias; GET /api/loads[/:id],
POST .../cancel, DELETE .../:id y DELETE ...?subscription_id= para
borrar historial terminado —409 si hay carga activa—): modos merge
(defecto), empty y drop (estos dos exigen destino SQL/mongo/ES; kafka
rechaza la carga con 501: es solo streaming, basta activarla). Antes de
encolar, la carga exige destino accesible y origen activo (409 si alguno
está parado) y tablas listas (409 en vez de morir a mitad). La capacidad la
marca max_loads por destino (las demás esperan en cola); al reiniciar, las
interrumpidas se aparcan como canceladas y las encoladas se reanudan solas
(Resume). Cada ejecución muestra su antigüedad (hace 20h:30m).
Journal (GET /api/journal/status, journal.read): checkpoints
high_water_seq por suscripción. System/Health (GET /api/system,
/api/health, más el agregado GET /api/health/endpoints con destinos y
orígenes, suscripciones y backlog): salud global con accesibilidad de
destinos. MQ (GET /api/mq/status): tópicos adasync.<dbid>.<FNR> con
offsets y checkpoints; inspección (GET .../topics/:topic/messages), purga
(POST .../purge {mode: all|to_offset, offset}, mq.manage) y borrado
(DELETE, mq.manage). La retención del broker + la purga diaria de
audit/DLQ (callRetentionDays) acotan el disco.
DLQ (GET /api/dlq, dlq.view): entradas con error; replay
(POST /api/dlq/:id/replay) y borrado (DELETE, dlq.replay). El replay
rechaza campos sin mapeo (unmapped fields… check catalog) en vez de
corromper el destino; los borrados se reintentan por ISN sin decodificar
imagen.
Cambios de estructura: no hace falta carga inicial
La carga inicial es solo el backfill: una vez que la suscripción está en streaming, el esquema puede evolucionar sin volver a cargar. Los tres escenarios habituales:
| Escenario | Qué hacer | ¿Carga inicial? |
|---|---|---|
| Cambia el Adabas (campo nuevo en el fichero, DDM actualizado) | Recargar el diccionario (POST /api/adabas/:db/reload), añadir el campo al mapeo de la suscripción y pulsar Aplicar al destino (POST .../align-columns): añade la columna a la tabla existente sin tocar datos, contadores ni checkpoint | No |
| Cambia el destino (columna nueva, tipo corregido) | El upsert respeta la columna; si el tipo no encaja, se corrige con Aplicar al destino o con DDL manual | No |
| Se borra la tabla del destino | La suscripción pasa a sin_tabla y el worker se aparca en el broker (no es un error ni llena la DLQ); al recrearla (Preparar → Crear tabla) reanuda el backlog | No |
Si llega un campo que no está en el diccionario ni en el mapeo, el apply se
rechaza con el detalle unmapped fields… check catalog y la entrada va a la
DLQ: se corrige el mapeo y se hace replay — tampoco hace falta cargar.
Nota:
align-columnssolo aplica a destinos SQL (501 en mongo, ES y kafka: allí los documentos, índices y tópicos se materializan con la propia escritura).
Grupos PE y campos múltiples MU
El tratamiento de los grupos y el de los campos múltiples se eligen por separado, en el destino y en cada suscripción (la suscripción manda sobre el destino; vacío = heredar):
| Selector | Valores | Afecta a |
|---|---|---|
| Grupos (PE) | json | child | grupos periódicos y grupos con subcampos |
| Campos múltiples (MU) | json | flat | child | campos con múltiples ocurrencias (MESES, DES-BENEFICIARIO…) |
| Máx. ocurrencias | 1…999 (solo suscripción) | obligatorio si el modo MU es flat |
- Grupos
json: el grupo periódico entero viaja como un documento JSON (arrays nativos en MongoDB/ES/Kafka).child: tablas hijas normalizadas, resueltas igual en el DDL, las cargas y los applies. - Campos MU
json: todas las ocurrencias en una columna JSON.child: una fila por ocurrencia en una tabla hija (columnaVALUE).flat: las ocurrencias se despliegan en columnas numeradas de la misma tabla: siMESEStiene 8 ocurrencias y el modo esflatcon máximo 8, la tabla llevaMESES_1,MESES_2…MESES_8.
-- Destino SQL con un campo MU de 8 ocurrencias en modo flat (max 8)
CREATE TABLE "CLIENTES" (
  "ISN_CLIENTES" INTEGER PRIMARY KEY,
  "MESES_1" TEXT, "MESES_2" TEXT, "MESES_3" TEXT, "MESES_4" TEXT,
  "MESES_5" TEXT, "MESES_6" TEXT, "MESES_7" TEXT, "MESES_8" TEXT,
  ...
);
Detalles del modo flat de un campo MU:
- El número de ocurrencias se indica en la suscripción
(
mu_flat_max, 1…999) y es obligatorio cuando el modo esflat; sin él la API responde 400. - Al aplicar un registro, la 1.ª ocurrencia va a
MESES_1, la 2.ª aMESES_2, etc.; las que falten quedan a NULL. - Si el registro trae más ocurrencias que el máximo, se conservan las
primeras y las demás se descartan con un aviso en el log de la suscripción
(
logs/subs/<id>.log): la réplica sigue, no se rompe el flujo. - Sirve igual en SQL y en documentos (MongoDB, Elasticsearch, Kafka): allí el campo se guarda con los mismos nombres numerados.
- El DDL se genera con los nombres numerados, y Aplicar al destino
(
align-columns) añade las columnas que falten sin tocar datos, contadores ni checkpoint. - El compare origen ↔ destino compara cada ocurrencia con su columna.
El modo explícito de un campo en el mapeo (columna «Modo») manda sobre el
selector: un campo MU puede marcarse como flat aunque el destino use
json. Con groups_as_json el destino colapsa además los grupos simples a
una columna.
La identidad es isn (o ISN_<TABLA> con isn_named) y el conflicto se
resuelve con upsert + guarda _seq (un evento tardío nunca pisa a uno
nuevo).
Línea de comandos
nsadasync init ./prod                        # proyecto (config 0600, db, admin)
nsadasync token ./prod --name poller --scope VENTAS --days 365 --cidr 10.0.0.0/8
nsadasync token ./prod --list                # prefijo, nombre, scope, caducidad, revocados, último uso
nsadasync token ./prod --revoke nstm_a1b2c3d4
nsadasync passwd ./prod admin [nuevapass]    # emergencia (mín. 8 caracteres)
nsadasync start|stop|status ./prod [--port N]
nsadasync license                            # estado, tipo, caducidad, fingerprint
Notificaciones por correo
NSAdaSync puede avisar por correo cuando algo cambia en la réplica. El
motor evalúa el estado (destinos, orígenes, suscripciones, DLQ, cargas y
licencia) y avisa solo cuando algo cambia, no en cada comprobación; si
el problema persiste, lo recuerda cada reminder (4 h por defecto) y avisa
de la recuperación a los mismos destinatarios que el aviso original.
Se activa y ajusta en la consola (Configuración → Notificaciones) o en
config.yaml (sección notify):
notify:
  enabled: true
  methods: email
  recipients:
    critical: ["dba@empresa.com"]
    warning: ["equipo-datos@empresa.com"]
    info: []
  intervalSec: 60
  reminder: 4h
  quiet: { enabled: false, from: "22:00", to: "07:00" }
  rules:
    destination_down: { enabled: true, severity: critical }
lag_high: { enabled: true, severity: warning, threshold: 1000 }| Suceso | Severidad | Cuándo salta |
|---|---|---|
destination_down | crítica | un destino no responde (los cambios se encolan) |
origin_stopped | crítica | un origen está parado con suscripciones activas |
dlq_pending | crítica | hay cambios sin aplicar en la DLQ |
load_failed | crítica | una carga inicial termina en error |
subscription_error | aviso | una suscripción queda en error |
table_missing | aviso | falta la tabla en el destino (backlog esperando) |
lag_high | aviso | más cambios encolados que el umbral |
destination_slow | aviso | latencia del destino por encima del umbral |
broker_disk | aviso | el broker de la cola cerca del límite de disco |
license_expiring | aviso | la licencia caduca en pocos días |
login_failures | aviso | varios intentos de acceso fallidos seguidos |
destination_recovered | info | un destino vuelve (se aplica el backlog) |
load_ok | info | una carga inicial termina bien |
subscription_change | info | alta o cambio de una suscripción |
Desde el CLI: nsadasync notify test [destinatario] envía un aviso de
prueba y nsadasync notify status muestra las reglas, las incidencias
abiertas y los últimos avisos enviados. El historial queda registrado y
consultable en la consola y en GET /api/notifications.
Programación
NSAdaSync lleva su propio motor de programación (no usa el cron del sistema): cada 30 s evalúa las reglas y dispara las que tocan. En la consola está en Programación (menú lateral) y el Panel muestra cuántas reglas hay programadas y cuál es la próxima ejecución.
Ventana de mantenimiento: pausa la replicación de un origen, un destino o de todos entre dos horas (recurrencia diaria, semanal, mensual o una vez). Durante la ventana los cambios se encolan en el broker y se aplican al terminarla. Al abrirla se guarda el estado previo de cada endpoint, así que:
- lo que ya estaba parado a mano no se toca;
- al cerrarla se reanuda solo lo que la ventana paró;
- la consola distingue «parado a mano» de «pausado por ventana».
Tareas programadas: una carga inicial (merge/empty/drop) o una
comparación origen↔destino de una suscripción, con hora y recurrencia. Si
ya hay una carga en curso, la tarea se omite y se avisa por email; con
catch_up se ejecuta aunque la hora haya pasado mientras el servidor
estaba parado.
Lo voluminoso no se guarda en la base de datos: el detalle de una
comparación (hasta 200 diferencias con valores) se escribe en un fichero JSON
del directorio de datos (compares/*.json); en la base queda el resumen
(contadores + extracto de 10 diferencias + la ruta del fichero) y el
historial de ejecuciones, acotado.
Cada aviso por email (apertura y cierre de ventana, tarea omitida, error, carga terminada y resultado de la comparación) lleva la fecha y hora del suceso.
GET  /api/schedules · /api/schedules/summary · /api/schedules/runs
GET  /api/schedules/compares   (resúmenes de las comparaciones)
POST /api/schedules · POST /api/schedules/:id/run
PUT/DELETE /api/schedules/:id
El historial está acotado y se purga con la retención habitual (30 días por
defecto): los avisos, las ejecuciones (las 20 últimas por regla), los
resúmenes de comparación y los ficheros de detalle compares/*.json.
Desde el CLI: nsadasync schedule list y nsadasync schedule rm <id>.
Usuarios, grupos y permisos
RBAC de un solo tenant: roles de sistema Admin (todo), SyncOperators
(operar suscripciones, destinos, journal, loads y DLQ: dashboard.view,
subscriptions.view, destinations.view, journal.read, loads.run,
dlq.view, dlq.replay, calls.view, logs.view) y Viewers (solo
lectura); grupos Administrators, Operators, Readers. El catálogo se
refresca en cada arranque. Usuarios (GET/POST /api/users,
PUT/DELETE /api/users/:id, PUT .../active, PUT .../groups, todo con
users.manage); roles y grupos solo se listan (GET /api/roles,
/api/groups). Recuperación por email (/forgot-password,
POST /api/auth/forgot-password, POST .../reset-password) si el correo
está configurado; si no, nsadasync passwd.
| Permiso | Cubre |
|---|---|
dashboard.view | Panel y estados |
subscriptions view|manage | Ver / crear, editar, borrar, ensure-table, align-columns, duplicar, debug |
destinations view|manage | Ver, ping / crear, editar, borrar, test |
journal.read | Journal, system, health (+endpoints), MQ (lectura) |
mq.manage | Purga y borrado de tópicos |
loads.run | Lanzar, cancelar y borrar cargas |
dlq view|replay | Ver / reintentar y borrar entradas |
calls.view, logs.view | Llamadas y auditoría/logs |
tokens view|manage | Ver / crear, revocar y borrar tokens |
users.manage | Usuarios, roles y grupos |
config.manage | Configuración, email de prueba, orígenes y diccionarios |
Los tokens máquina (nstm_..., solo se muestran una vez) llevan scope
de suscripción o all, caducidad (--days, 0 = nunca) y allowlist de
CIDRs/IPs; se guardan como HMAC-SHA256 con el pepper (rotarlo los invalida
todos). La API máquina (/api/ext) está deshabilitada en esta versión: todo
el tráfico es consola local o loopback.
API (cookie JWT; error {"ok": false, "error": msg})
POST /api/auth/login · /api/auth/refresh · POST /api/auth/logout
POST /api/auth/forgot-password · POST /api/auth/reset-password
GET  /api/auth/me · POST /api/auth/{theme,language}
GET  /api/version · /api/license · /api/docs · /api/openapi.yaml
GET  /api/subscriptions · /api/subscriptions/states · /api/subscriptions/check-name
POST /api/subscriptions · PUT/DELETE /api/subscriptions/:id
GET  /api/subscriptions/:id/log · DELETE .../log
POST /api/subscriptions/:id/{debug,reset-counters,ensure-table,align-columns,prepare,duplicate}
POST /api/subscriptions/{preview-ddl,validate-fields}
POST /api/subscriptions/:id/compare · GET .../compare · POST .../compare/cancel
GET  /api/subscriptions/:id/origin-rows
GET  /api/adabas/databases · GET /api/adabas/:db/files[/:fnr[/raw]]
GET  /api/adabas/:db/missing-subscriptions · GET /api/mapping-template
PUT/DELETE /api/adabas/databases/:db · POST /api/adabas/:db/{dictionary,reload}
GET  /api/adabas/:db/probe · POST /api/adabas/:db/validate
GET  /api/destinations · /api/destinations/drivers
POST /api/destinations · PUT/DELETE /api/destinations/:id
POST /api/destinations/:id/ping · POST /api/destinations/test
GET  /api/destinations/:id/tables[/:table/rows]
POST /api/loads[/batch] · GET /api/loads[/:id] · POST /api/loads/:id/cancel
DELETE /api/loads/:id · DELETE /api/loads?subscription_id=
GET  /api/journal/status · /api/system · /api/health · /api/health/endpoints
GET  /api/mq/status · GET /api/mq/topics/:topic/messages
POST /api/mq/topics/:topic/purge · DELETE /api/mq/topics/:topic
GET  /api/dlq · POST /api/dlq/:id/replay · DELETE /api/dlq/:id
GET  /api/users · /api/roles · /api/groups · /api/tokens · /api/audit
GET  /api/config · PUT /api/config · GET /api/config/disk · POST /api/config/test-email
Todo queda en auditoría (LOGIN/LOGOUT/LOGIN_FAILED, SUBSCRIPTION_*,
DESTINATION_*, ORIGIN_DELETE, TABLE_CREATE/TABLE_DROP*/TABLE_ALIGN,
LOAD_*/LOADS_DELETE, PREPARE, MQ_TOPIC_*, DLQ_*, TOKEN_*,
USER_*, CONFIG_SAVE, EMAIL_TEST, PASSWORD_*, con IP de cliente). La
sesión dura jwtExpiryMin (defecto 15 min); al caducar, la consola vuelve al
login.
Seguridad
- JWT HS256 con caducidad configurable (defecto 15 min; sin refresco silencioso: al expirar se pide login), anti-bruteforce en login/reset, contraseñas con bcrypt (coste 12) y reseteo con tokens de un solo uso.
config.yaml(0600) y DB (0700); secretos redactados enGET /api/configy nunca en logs; tokens máquina por hash HMAC + prefijo visible, con CIDR allowlist y expiración.server.trustedProxies(defecto loopback) para no falsificar la IP de auditoría/rate-limit; cookiesSecureen auto (TLS/X-Forwarded-Proto); cabecerasContent-Security-Policy,X-Content-Type-Options,Referrer-PolicyyPermissions-Policy.- Validación y saneado de DBIDs, FNRs, nombres de suscripción/tabla, DDL,
DSNs y rutas (
config_file,path,pipe/journal); los topics son siempre numéricos y el agente remoto no existe aquí (todo es local).
Estado y control de la instalación
- Arranque y parada:
nsadasync init|start|stop|status <dir>; el proceso arranca el supervisor de forward, el broker embebido y los workers de las suscripciones activas, y los detiene de forma ordenada al parar. - Estado:
nsadasync status <dir>y el Panel de la consola (orígenes, destinos, suscripciones, encolados, DLQ, salud de la cadena). - Reanudación: al reiniciar, las cargas interrumpidas quedan canceladas y las encoladas se reanudan solas; el backlog del broker se reaplica en orden y cada suscripción continúa desde su checkpoint.
- Operación por CLI:
nsadasync passwd <dir> <usuario> [password](recuperar acceso),nsadasync token <dir> --name … --scope … --days …(tokens de máquina) ynsadasync license(estado de la instalación). - Auditoría: todas las acciones quedan registradas en la consola
(
LOGIN,SUBSCRIPTION_*,DESTINATION_*,LOAD_*,DLQ_*,TOKEN_*,USER_*,CONFIG_SAVE…) con usuario e IP de cliente, y en el log de cada suscripción (logs/subs/<id>.log).
Solución de problemas
- El exit no emite (streaming parado pero las cargas funcionan): además
de
ADAUEX_4,USEREXITS=4y CLOG+LOGRB, verifica que elLOGGING=(CB)sea efectivo: una líneaLOGGING =vacía posterior en el INI lo anula en silencio (no sale en el PARSET) y la exit no recibe ningún cambio. ConNSADASYNC_EXIT_DEBUG_FILEobtienes la traza de init y cada evento pipe/journal. adaopr db=<id> disp=hiaborta con Signal 8: es un bug de Software AG (divpor cero endis_hwmdelibadautl.soal formatear high-water marks), no de la exit: el núcleo sigue vivo. Evita ese display.- El forward no publica: comprueba el
pipe_path/journal_pathde la fila Origins, el spool por origen y que el supervisor lea el FIFO (log[FORWARD]); sin lector, la exit vuelca al journal y el supervisor lo reinyecta al volver. - Destino caído: los cambios se encolan en el broker (verdad en el
panel de destinos: encolados por punto) y reanudan solos; nada va a la
DLQ. Revisa con ping/test,
GET /api/health/endpointsyGET /api/destinations/drivers(el build puede no traer ese driver). Las cargas iniciales se niegan con 409 hasta que el destino responde. - Origen parado: la carga inicial se niega con 409; el streaming simplemente no recibe más cambios (el backlog se conserva).
- Suscripción
sin_tabla: estacionamiento, no error — crea la tabla (ensure-table) y reanuda el backlog del broker (en kafka, activa: el tópico se crea solo). diferentepermanente: normal en vivo (retardo transitorio); si el contenido diverge, lanza un compare por ISN.- DLQ con
unmapped fields: el DDM no cubre esos campos — amplía el diccionario o el mapeo y haz replay. - Carga atascada en
cargando/en_cola: miraGET /api/loads/:id(capacidadmax_loadspor destino); cancélala y relánzala; al reiniciar, las interrumpidas se aparcan solas. El historial se borra por entrada o entero (DELETE /api/loads[/:id]). - Editaste el mapping y faltan columnas: usa Aplicar al destino (solo añade columnas, sin resetear nada).
- Compare con 409: ya corre uno en esa suscripción (un compare por vez); cancélalo o espera.
- Token rechazado: revisa scope, CIDR y caducidad; si rotaste el pepper, reemite todos los tokens. La API máquina está deshabilitada en esta versión.
- Sin ficheros en el origen: revisa
config_file(JSON nsddm válido, ≤ 8 MiB) yconnect; usa probe/validate del origen. - Sesión caducada: vuelve al login (sin refresco silencioso); ajusta
jwtExpiryMinsi necesitas sesiones largas. - Puerto ocupado: cambia
server.port(11035) enconfig.yaml.